AI 编程中的 Plan Mode:计划仍然需要,但不必逐行细看
作者:吴穹
本文首发于 Agilean 微信公众号
公众号原题:《Plan Mode没死,只是Plan不需要细看了》
最近,海外开发者社区有一篇文章很火,标题很直接:《Plan mode is dead》。作者Ayman Nadeem不是站在旁边评论,他曾经非常相信Plan Mode,甚至围绕这个想法做了一款桌面编程产品Nuanced。在他的设想里,人先和Agent讨论需求,Agent负责澄清问题、生成规格,人审阅并批准计划,然后Agent才开始写代码。这条链路很完整,也很符合我们熟悉的软件工程逻辑。
但产品没有成功。他后来复盘,问题并不是规划没有价值,而是他们把Planning和Plan混在了一起。共同思考是一回事,把思考结果保存成一份冗长的AI文档,又是另一回事。用户愿意参与讨论,却不愿意阅读一份越来越长的规格;与此同时,模型已经可以自己理解代码库、补足大量实施细节,并在执行过程中根据结果调整方向。于是作者得出了那个吸引眼球的结论:Plan Mode已死。
我的看法没有这么绝对。
Plan Mode没有死。真正开始过时的,是让人类逐字阅读完整计划,再批准Agent开始工作的方式。
我为什么越来越少看Cursor的Plan
我以前使用Cursor的Plan Mode,会比较认真地读它生成的每一步:改哪些文件,增加哪些接口,采用什么顺序,补哪些测试。计划写得越完整,似乎就越有安全感。后来模型越来越强,计划也越来越长,一份计划可能写得非常专业,结构清晰、步骤完整,几乎挑不出明显错误,但读完以后,我经常发现真正需要我判断的内容只有很少一部分。
它先读取哪个文件,准备创建什么辅助函数,使用哪条命令跑测试,这些内容并不值得持续占用我的注意力。Agent在执行时还会遇到新的代码、新的报错和新的约束,原来的实施步骤本来就会变化。真正值得我停下来的,是它有没有理解错目标,做了什么关键假设,会不会破坏已有架构,有没有遗漏安全、数据和兼容性风险,以及最后用什么证据证明事情真的做完了。
人需要审查的是决定,不是动作清单。
如果为了找到几个真正重要的决定,我必须先读完几千字计划,那么Plan Mode就从控制工具变成了认知负担。
现在,我已经很少细看Cursor最终生成的完整Plan。我更愿意先和Cursor里的Composer 2.5讨论,把模糊想法聊清楚,让它读取代码、比较方案、暴露约束,再形成一份候选计划。随后,我把原始意图、关键代码证据、候选计划和验收标准一起交给Grok评审。
我要求Grok不要再写一份更长的计划,而是告诉我:哪些判断可以保留,哪些假设证据不足,最大的风险在哪里,遗漏了什么验收条件,最后到底是可以执行、需要修改,还是应该停下来重新想。我主要阅读这些结论,只有碰到真正影响产品、架构或者风险边界的分歧时,才进一步介入。
完整计划仍然有用,只是它更多成为Cursor、Grok和后续执行Agent之间的工作语言。对我来说,更重要的阅读界面已经从Plan变成了一份简短的Decision Memo。
低成本模型负责把问题展开,强模型负责把判断压缩,人只在关键分歧上投入注意力。
Claude的流程,表面传统,内核已经变了
前几天我们讨论了Anthropic发布的《AI-Native SDLC Playbook》。它看起来仍然是一套非常重视Plan的研发流程:团队先写intent.md或者spec.md,说明要解决的问题、用户和约束;Claude进入Plan Mode,读取意图、规格和代码库,再生成plan.md。
这份计划要明确修改哪些文件、按照什么顺序实施,以及用什么测试证明结果。工程师还要追问:这个改动可能破坏什么?风险最高的是哪一步?Claude放弃了哪些方案?计划批准以后,Claude执行修改;实现如果偏离计划,就同步更新plan.md;到了PR阶段,再拿最终Diff、测试结果和原始意图进行对照。
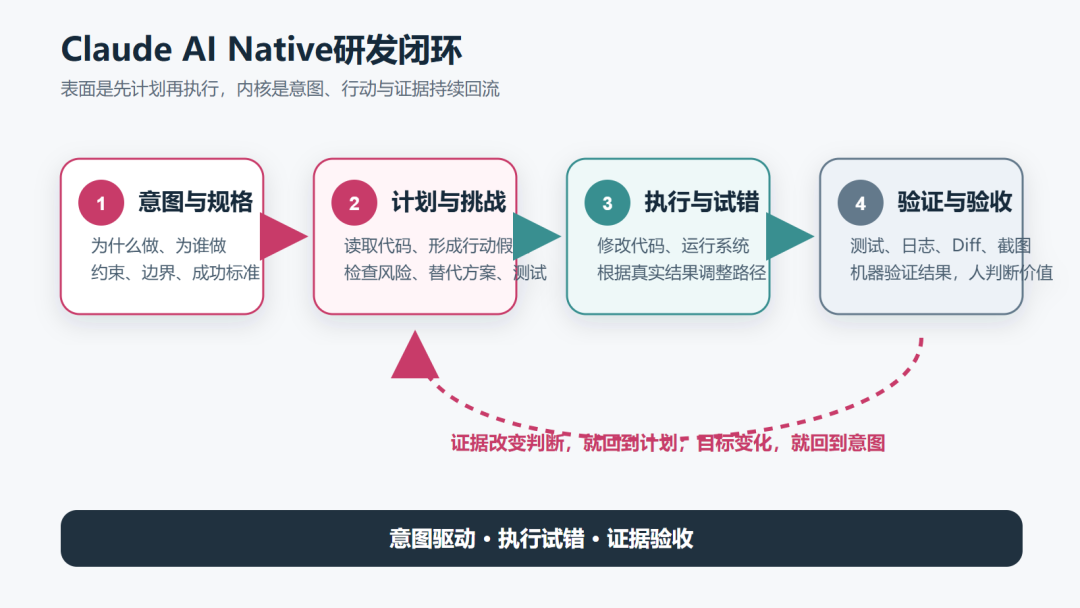
Claude AI Native研发闭环:意图驱动、执行试错、证据验收
如果只看文件名,这仍然像一条传统流水线:意图、规格、计划、开发、测试、评审。但真正支撑这套流程的,并不是文件交接,而是一条始终没有断开的证据链。意图约束计划,计划指导执行,执行接受验证,验证结果又可能迫使团队回到计划,甚至重新检查意图。
它的表面是“先计划、再执行”,内核却是“意图驱动、执行试错、证据验收”。
传统计划假设,我们可以在开工前把事情基本想清楚;AI Native研发则承认,很多问题只有在Agent真正读取代码、运行程序、看到报错甚至打开页面以后,才会显现出来。计划不再是一份不能违背的施工图,而是当前最好的行动假设。证据一变,计划就应该跟着变。
Anthropic后来发布的Claude Code高级用户技巧把这一点说得更加直接:如果只能采用一种实践,就采用验证,让Claude能够检查自己的输出。这句话实际上重新安排了研发的控制点。我们仍然要在执行前确认意图和高风险判断,却不必假装所有实施问题都已经解决。Agent可以行动,可以试错,也可以根据测试和运行结果改变路径。
旧的循环是:
计划 → 批准 → 执行
新的循环更像:
理解 → 行动 → 检查 → 澄清 → 调整 → 再行动
这里并没有少做Planning。
Planning只是从一个前置阶段,进入了整个研发过程。
强模型应该评审两次
我现在采用的是一种前后夹击的做法。执行前,Grok评审候选计划,负责发现目标误解、错误假设、架构风险和验收缺口。人只处理真正需要负责的分歧,确认以后再把方案交给Cursor执行。这样做的目的不是追求一份完美计划,而是在大量代码出现以前,把最昂贵的方向错误拦下来。
执行过程中,Cursor可以读代码、改代码、跑测试、看日志,也可以根据真实结果修正实施步骤。普通错误不需要每次回来问人,只有方向发生变化、重复试错仍不收敛,或者碰到安全、数据和不可逆操作,才重新升级。Agent获得了行动空间,但这种空间始终受到意图、测试和风险边界约束。
执行完成以后,我准备让Grok再做一次验收。第二次不是重新评审原来的计划,而是把原始意图、第一次评审结论、最终Diff、测试结果、运行日志和页面截图放在一起,检查三个问题:实现有没有偏离意图?第一次指出的风险有没有关闭?当前证据是否真的足以宣布完成?
这两次评审承担完全不同的责任。第一次防止团队在错误方向上跑得很快,第二次防止团队用一份漂亮的完成报告掩盖真实问题。
执行前评审方向,执行后评审证据。
最后仍然由人验收。代码正确、测试通过、页面能打开,都不自动等于产品有价值。用户是否愿意使用,业务问题是否真的被解决,某些看起来合理的变化是否伤害了体验,这些问题仍然需要人进入真实产品做判断。模型负责检查一致性,人负责确认价值。
人不是退出研发,而是换了位置
不再细看Plan,很容易被误解成放弃控制。但真正的问题从来不是“人看了多少文字”,而是“人有没有控制那些不能委托的决定”。如果一个工程师读完了五千字计划,却没有发现目标本身定义错了,他仍然没有真正掌控研发;如果他只读了一页评审结论,却准确处理了关键分歧,反而可能做出了更有效的控制。
我认为至少有三个位置必须由人守住。第一个是意图:为什么做、为谁做、什么结果值得追求,不能由模型根据代码库自行推断。第二个是关键分歧:涉及产品方向、架构边界、安全、权限、数据和不可逆操作时,模型可以提供意见,但决定必须明确回到人。第三个是产品验收:机器可以证明功能符合一组条件,却不能替产品负责人判断,这是不是一个值得交付的结果。
至于文件列表、普通重构、工具调用、反复测试和大量实现细节,可以让模型之间传递,让Harness保存证据。人不必为了证明自己仍然掌控研发,而把有限注意力消耗在所有过程信息上。
人类真正稀缺的,从来不是阅读计划的时间,而是做出高质量判断的注意力。
Plan Mode之后,是注意力闸门
我把这套工作方式称为注意力闸门工作流(Attention-Gated Development)。它不是在开发开始前设置一道巨大的审批门,而是在整个研发过程中设置少数几个闸门:意图是否清楚,关键风险是否经过挑战,执行是否提供证据,结果是否通过验收。
简单任务可以直接通过,高风险任务需要强模型和人介入,Agent能够凭借测试和证据自行闭环的部分,就不反复打断人。Plan仍然可以存在,复杂任务也仍然应该把计划落盘,避免跨会话丢失上下文;只是我们不再要求人逐字阅读整份计划,才能证明自己理解系统。
未来真正有价值的AI研发界面,不是生成一份更漂亮、更完整的Plan,而是直接告诉人:现在有哪两个决定必须由你做,哪三个风险还没有关闭,哪些证据表明任务已经完成。到了这个时候,计划依然存在,但人的注意力终于不再被计划绑架。
所以,如果再有人说Plan Mode已死,我的回答会是:
Plan Mode没死。只是Plan正在成为Agent之间的中间语言,而人类开始把注意力留给意图、关键判断和最终验收。